-
-
- tRNA修饰测序(tRAM-Seq)
- 单碱基D修饰测序(CRACI-Seq)
- cfRNA多修饰测序(LIME-Seq)
- 单碱基m6A 修饰测序(GLORI-Seq)
- 单碱基m5C 修饰测序(Bis-Seq)
- 单碱基m1A 修饰测序(m1A-MAP-Seq)
- 单碱基m7G 修饰测序(Alkaniline-Seq)
- 单碱基m7G修饰tRNA测序(TRAC-Seq)
- 单碱基ac4C 修饰测序(Reda C:T-Seq)
- 单碱基O8G 修饰测序(O8G miSeq)
- 2-溴丙烯酰胺辅助环化测序(BACS-Seq)
- 单碱基假尿嘧啶修饰测序(BID-Seq)
- 2'-O-甲基化修饰测序(NM-Seq)
- 2'-O-RiboMeth-Seq
-


-
GlycoChIP-Seq技术
技术简介
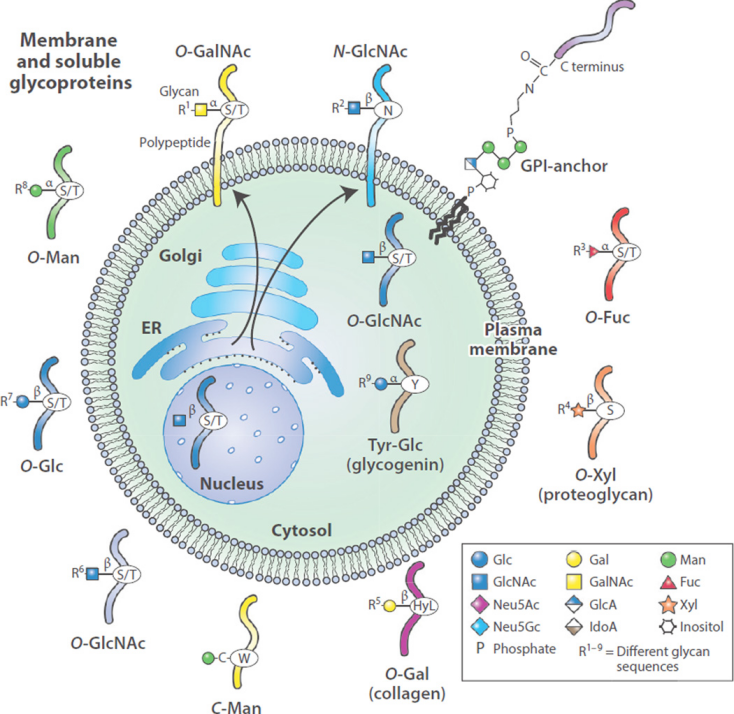
糖基化(Glycosylation)是指糖链或单糖通过酶促反应共价连接至蛋白质、脂质、RNA等生物大分子的过程。其中,蛋白质糖基化(Protein Glycosylation)是最丰富、最复杂的蛋白质翻译后修饰之一,主要包括N-糖基化(N-linked glycosylation)和O-糖基化(O-linked glycosylation),可通过影响蛋白质的结构、定位及分子互作,参与细胞信号转导、免疫调控、细胞黏附及疾病发生发展等过程。
图1. N/O-糖基化连接方式和分泌途径
传统糖蛋白研究主要聚焦于“哪些蛋白发生糖基化”以及“糖链结构是什么”,但难以解析糖基化相关信号在染色质及基因组上的分布特征,以及其与表观遗传状态的关联。
ChIP-seq可以通过特异性抗体富集与目标蛋白或染色质标记相关的DNA,并获得其全基因组分布。在此基础上,云序生物将“特异性抗体识别”替换为“凝集素识别糖链”,重磅推出GlycoChIP-seq技术,实现对糖基化相关染色质区域的富集与测序。该技术采用能够识别高甘露糖型N-glycan的Concanavalin A(ConA)凝集素作为识别分子,并通过ConA-生物素(biotin)与链霉亲和素(streptavidin)体系富集糖基化相关染色质片段。因此,GlycoChIP-seq可将传统糖蛋白研究从:“哪些蛋白发生糖基化?”进一步拓展到:“糖基化相关染色质在全基因组范围如何分布?”为解析糖基化与染色质及表观遗传调控之间的潜在联系提供全新的研究工具。
技术原理
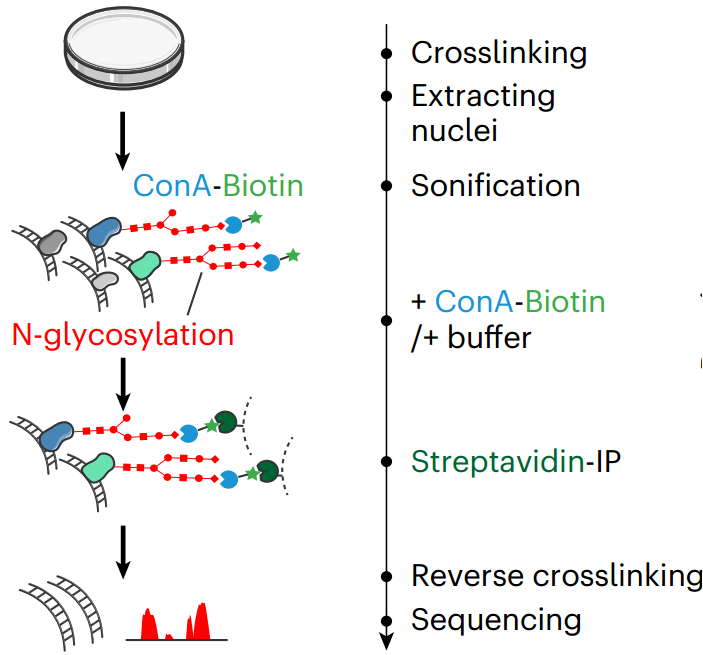
云序生物GlycoChIP-seq的核心原理是利用凝集素与特定糖链之间的高特异性识别,将糖基化相关染色质片段从全基因组染色质中选择性富集,随后进行测序和生物信息学分析:
Step 1|细胞处理与染色质固定
对细胞进行交联固定,使糖基化蛋白与染色质之间的空间相互作用得到稳定保存;
Step 2|细胞裂解与染色质片段化
裂解细胞,并对裂解物进行超声处理,将染色质打断成适宜长度的DNA片段,便于后续糖基化相关染色质的特异性富集;
Step 3|凝集素识别糖基化结构
加入ConA-biotin孵育,利用ConA对高甘露糖型N-glycan的结合能力,使糖基化相关染色质复合物获得生物素标记;
Step 4|Streptavidin磁珠富集
利用Streptavidin对biotin的高亲和力,富集ConA-biotin标记的糖基化相关染色质片段;
Step 5|洗脱与DNA纯化
从磁珠上洗脱富集的染色质,解除交联并纯化富集的DNA片段;
Step 6|高通量测序与生物信息学分析
对富集DNA进行测序文库构建,并通过高通量测序获得全基因组范围的糖基化相关信号。通过比对、peak calling、基因组注释,获得不同处理条件下糖基化相关的染色质状态变化。
图2 GlycoChIP-Seq实验流程
云序优势
从“蛋白质组”拓展至“基因组空间”:
传统糖蛋白质组学主要回答“哪些蛋白发生糖基化以及糖链结构是什么”,GlycoChIP-seq进一步将糖基化信号映射至基因组坐标,实现从蛋白质层面向基因组空间分布层面的拓展。
全基因组解析糖基化相关染色质区域:
可在全基因组范围检测糖基化相关染色质信号,为发现新的糖基化富集区域及潜在调控元件提供技术手段。
连接糖基化与三维基因组空间:
GlycoChIP-seq不仅能够分析糖基化信号的线性基因组位置,还可以结合核纤层相关结构域(LADs)、CpG密度及三维基因组数据,进一步解析糖基化相关信号与核周、核仁等染色质空间结构之间的关系。
可结合多组学数据解析潜在功能机制
GlycoChIP-seq获得的糖基化基因组图谱可进一步与ChIP-seq / ATAC-seq / CUT&Tag / RNA-seq等数据进行整合,从“糖基化定位”进一步探索其与染色质状态、转录调控及基因组稳定性的潜在联系。
相关产品
一、测序 · 糖基化RNA筛选
对糖基化小RNA进行定性和定量检测,全面涵盖rsRNA,tsRNA,Y RNA,miRNA,piRNA等多类小RNA。
Long GlycoRNA-seq:对200nt以上的长链糖基化RNA进行定性和定量检测,全面涵盖mRNA、LncRNA等多类长链RNA。
二、质谱 · 糖基化定性与定量
RNA N糖质谱分析:检测样本中N-糖基化修饰的种类及丰度。
RNA O糖质谱分析:检测样本中O-糖基化修饰的种类及丰度。
RNA N+O糖质谱分析:同时检测样本中N/O-糖基化修饰的种类与丰度。
GlycoRNA修饰质谱分析:探究GlycoRNA上是否共存其它RNA修饰类型。
多类RNA修饰质谱分析:检测60+种不同的RNA修饰类型,包含决定N糖附着的acp3U修饰。
三、验证 · 糖基化RNA靶向验证
GlycoRNA-qPCR:针对目标GlycoRNA设计特异性引物,快速验证测序结果的准确性与糖基化修饰的动态变化。
-
ꁸ 回到顶部
-
ꂅ 021-64878766
-
ꀥ 微信公众号二维码

-
-
高分文章案例
案例:核N-糖基化维持H3K9me3异染色质和基因组稳定性
原文:Nuclear N-glycosylation maintains H3K9me3 heterochromatin and genomic stability
发表时间:2026年4月28日
发表期刊:nature cell biology
影响因子:22.7
发表单位:中山大学
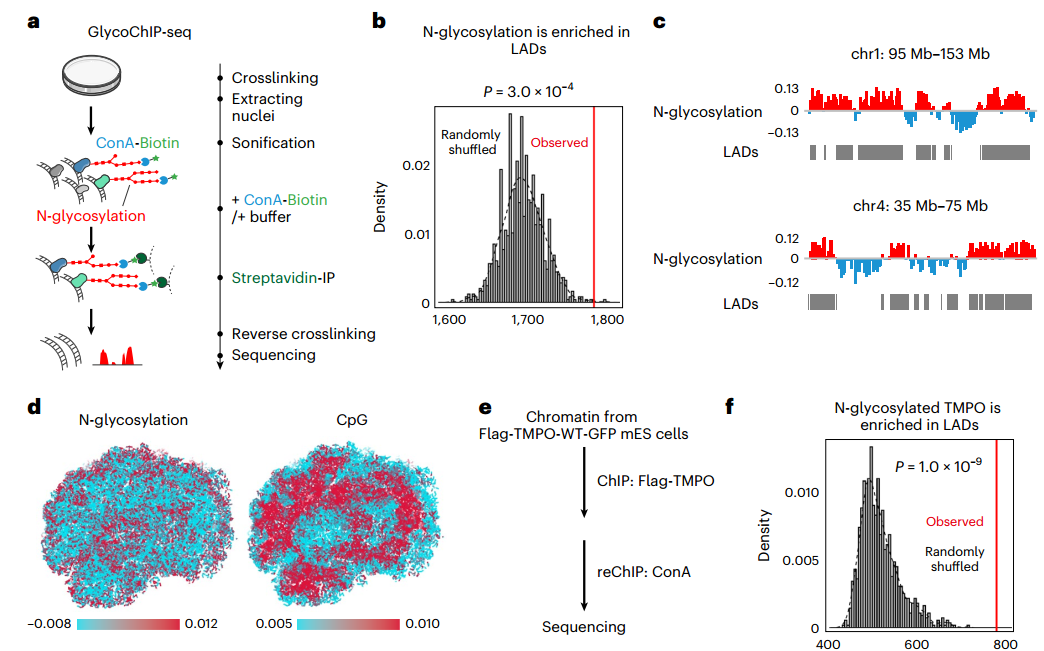
文章报道了N-聚糖对内核膜(INM)蛋白进行N-糖基化修饰,并首次揭示该修饰在细胞核内发挥重要的调控功能。通过GlycoChIP-seq技术,文章首次实现了在全基因组水平上对N-糖基化与染色质结合位点的精准定位,揭示了N-糖基化主要富集于H3K9me3标记的异染色质区域以及LINE-1反转录转座子位点,尤其是核纤层相关结构域(LADs)。在此基础上,研究发现N-糖基化抑制或内核膜蛋白TMPO的N-糖基化位点突变均会导致H3K9me3水平下降、LINE-1重新激活和基因组不稳定;机制上,N-糖基化通过维持TMPO与甲基转移酶SETDB1的相互作用,促进SETDB1在内核膜的锚定,从而维持H3K9me3修饰。此外,该修饰依赖于内质网中的经典N-聚糖合成途径,并需要Atlastin和核孔蛋白协助靶向定位至内核膜。总之,该研究不仅借助GlycoChIP-seq揭示了N-糖基化相关信号在细胞核内的全新分布和功能,也证明了其在染色质稳态和基因组稳定性维持中的重要作用,为多糖的生物学功能提供了全新的视角。
图3 N-糖基化和N-糖基化INM蛋白在染色质中富集
-
数据分析(仅供展示 详见demo报告)
一.分析项目
1.原始数据整理,Q30质控
2.接头去除和序列统计
3.序列匹配与数据统计
4.富集峰(糖基化蛋白结合的基因组片段)识别与注释
5.差异富集峰的鉴定和注释
6.差异富集峰相关基因GO分析
7.差异富集峰相关基因KEGG通路分析
8.富集峰韦恩图(Venn)
9.富集峰在全基因组上的分布特征(Classification)
10.富集峰在各染色图上的分布特征(Chrom Distribution)
11.富集峰长度分布特征(Length Distribution)
12.富集峰序列结构分析(Motif)
13.各组富集峰丰度热图(Heatmap)
14.不同样本间富集峰的分布差异聚类分析(Cluster)
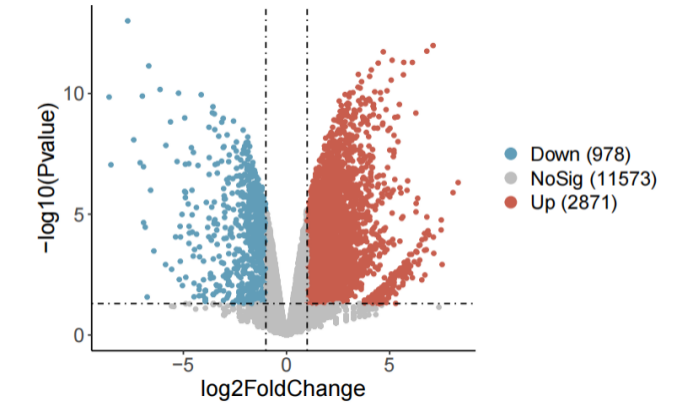
15.两组样本之间富集峰信号差异火山图(Volcano)
16.个性化分析
二.部分数据分析结果示例
1.差异富集区相关基因的GO分析和Pathway分析
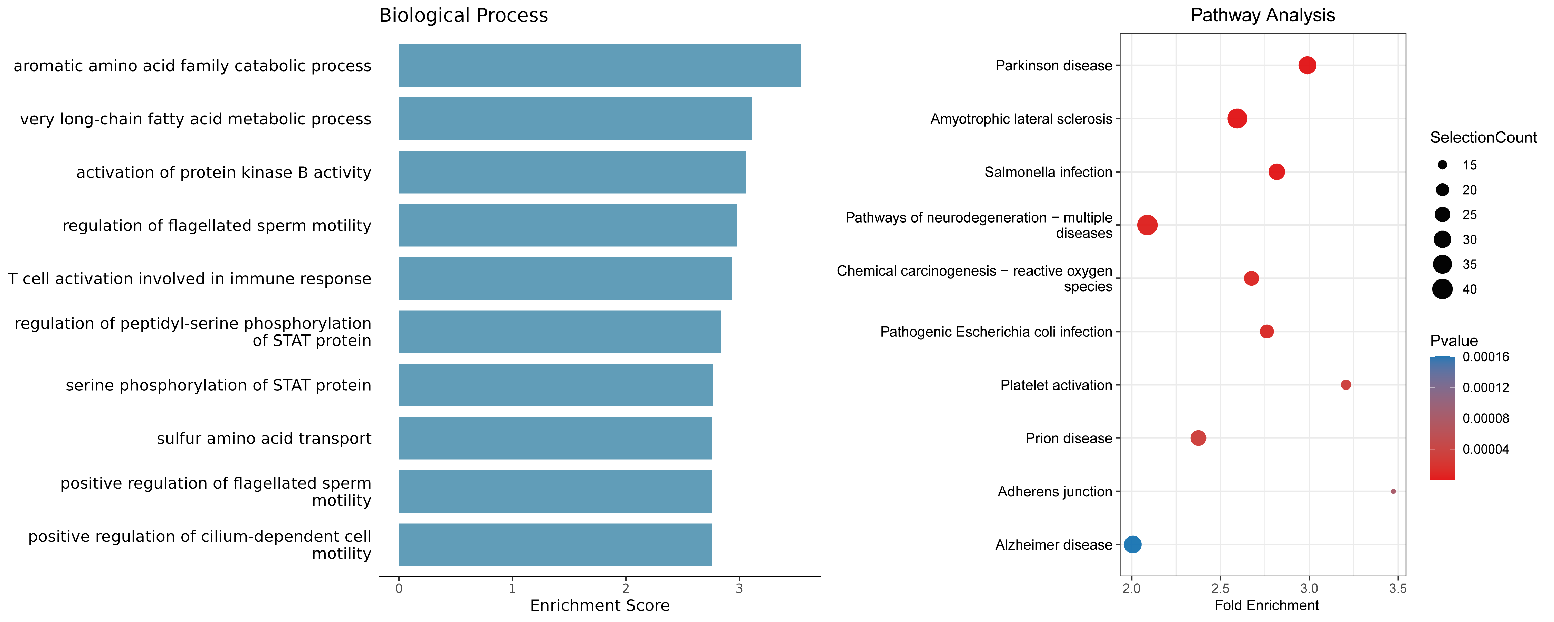
注释并推测这些富集峰可能参与的功能条目和通路。
2.糖基化富集区域(峰)Venn图
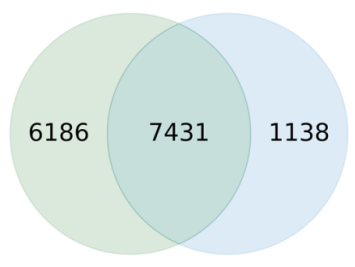
韦恩图(Venn)展示各组内独有的富集峰数目以及组间共有的富集峰数目。
3.富集峰在全基因组上的分布特征(Classification)
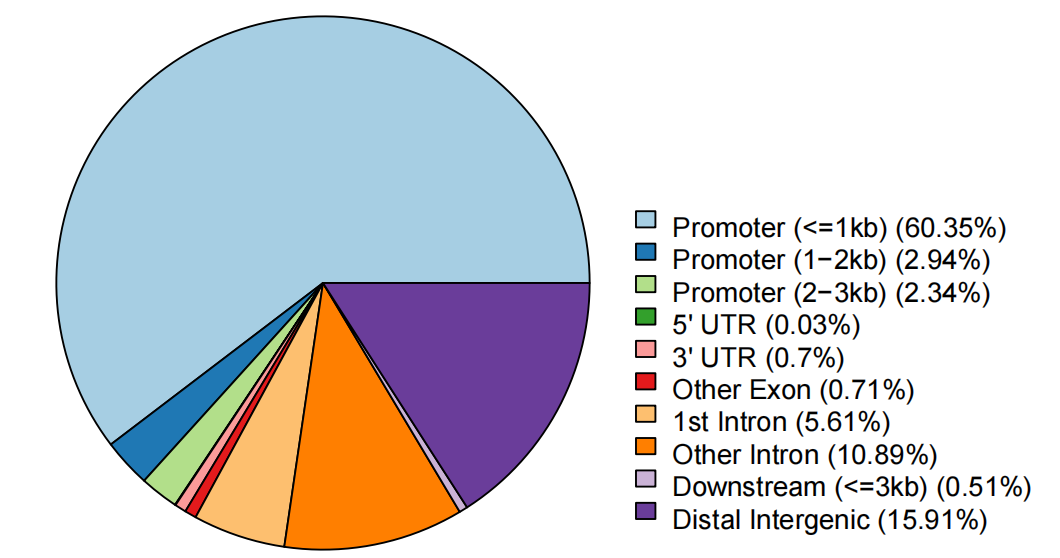
云序生物根据参考基因组注释文件,将基因组划分区域,再根据各富集峰的坐标信息,将富集峰匹配到各基因位置,统计各区域的富集峰所占比例,能够从总体上分析糖基化富集信号在基因组不同区域的分布特征。
4.富集峰在各染色体上的分布特征(Chrom Distribution)
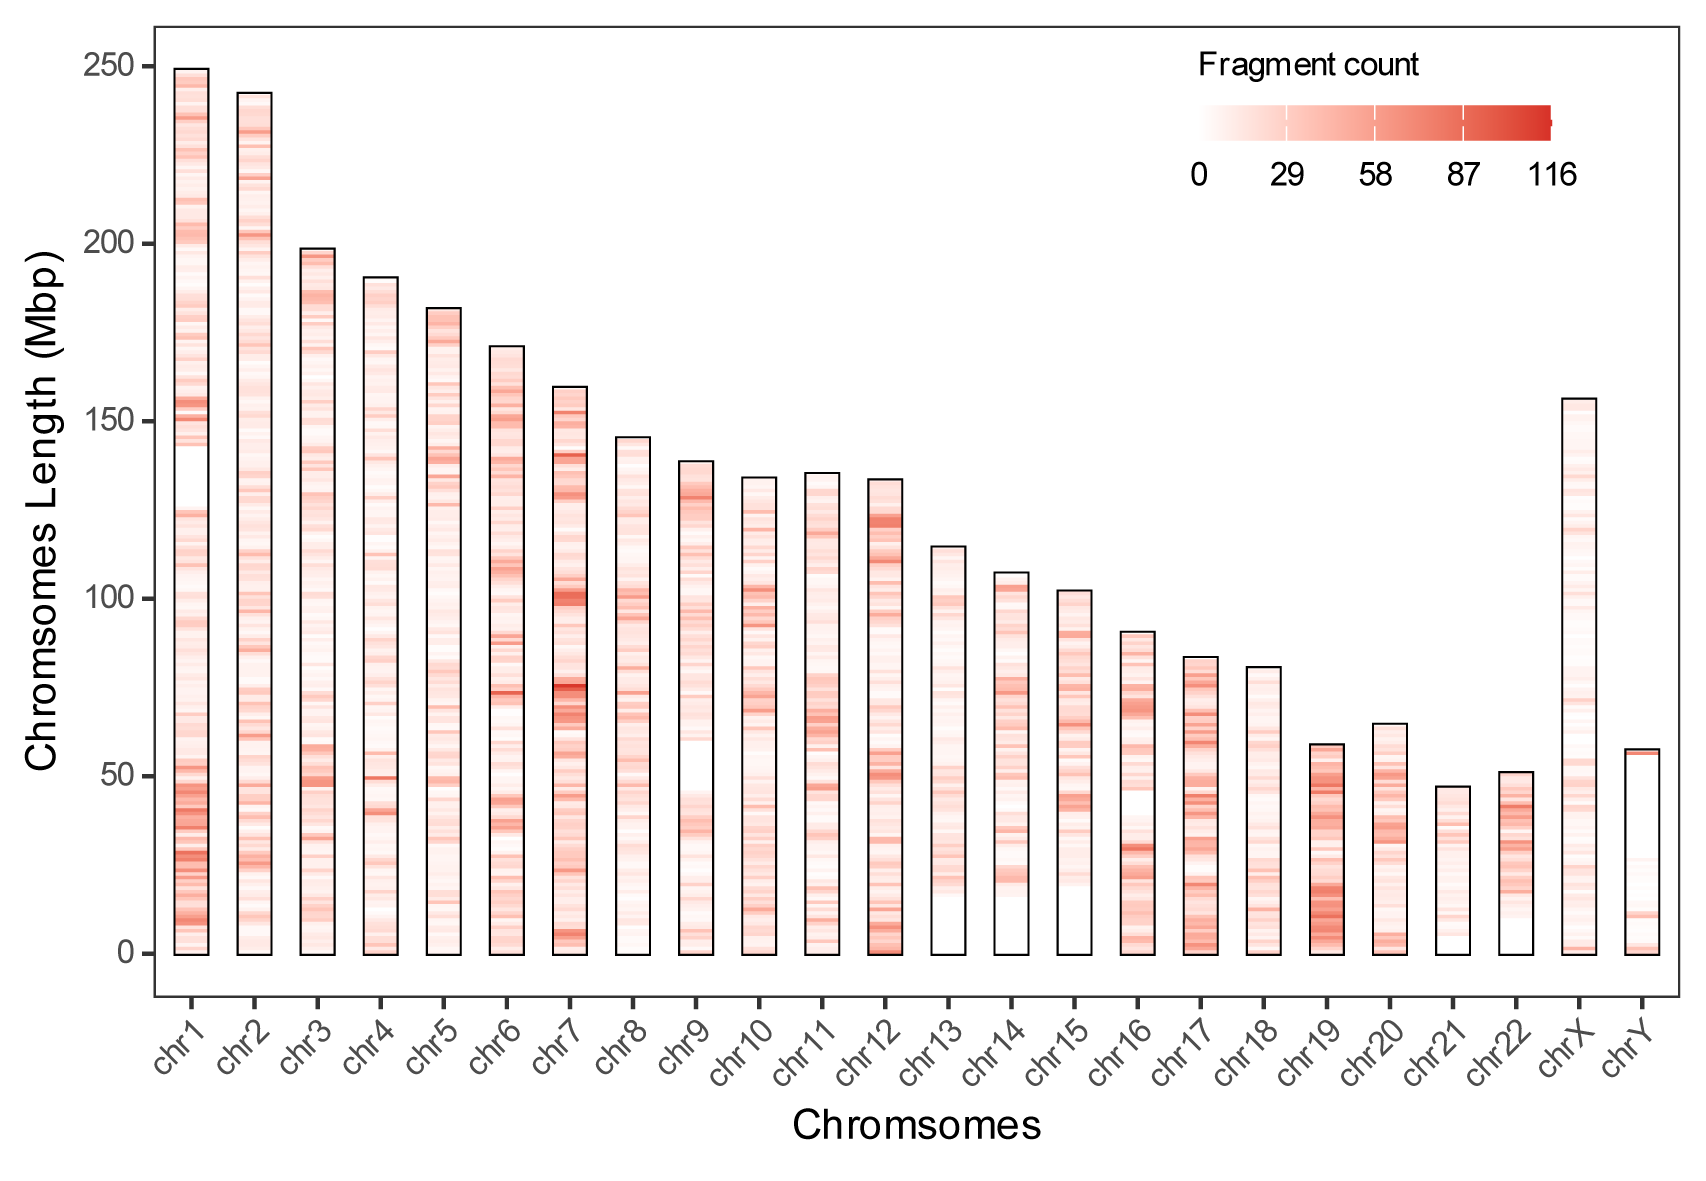
云序生物根据参考基因组注释文件,统计富集峰在各染色体上的位置,绘制各条染色体上富集峰分布的区域,从总体上探究糖基化的染色体偏好性。
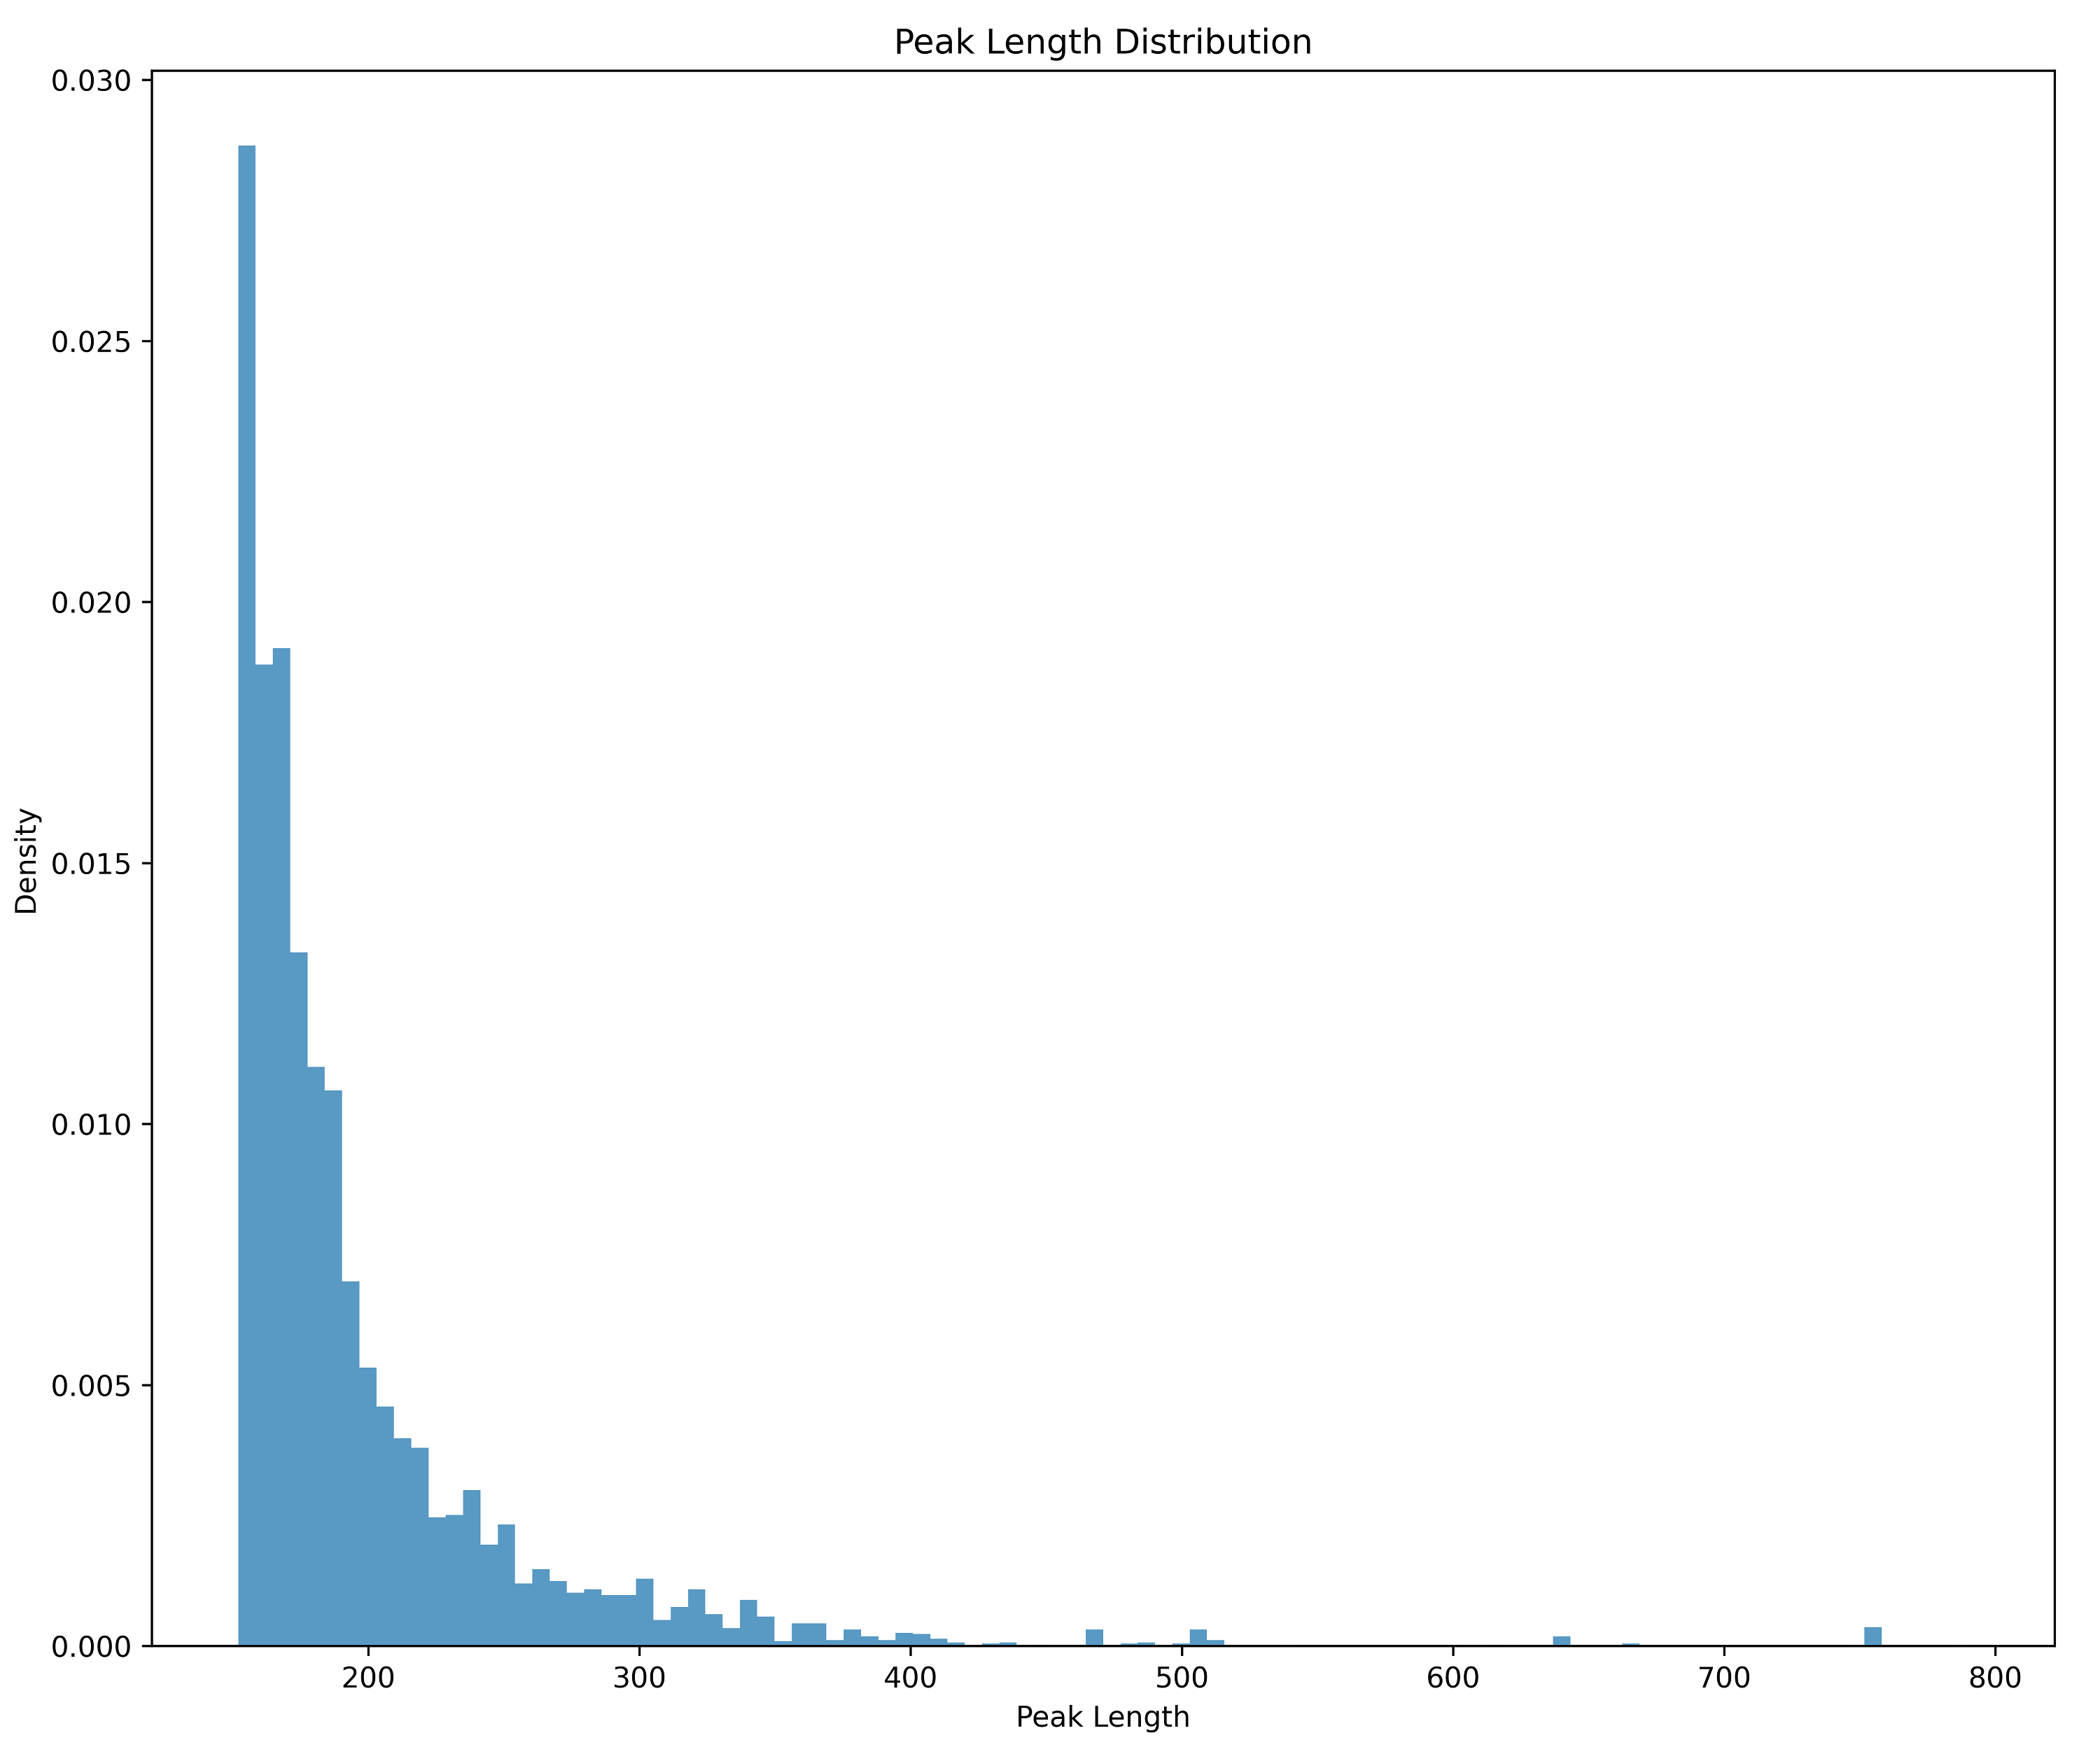
5.富集峰长度分布特征(Length Distribution)
统计富集峰的长度及数量,并绘制柱状图。通过观察长度分布图,能更好的从整体上观察到富集峰的长度属性。
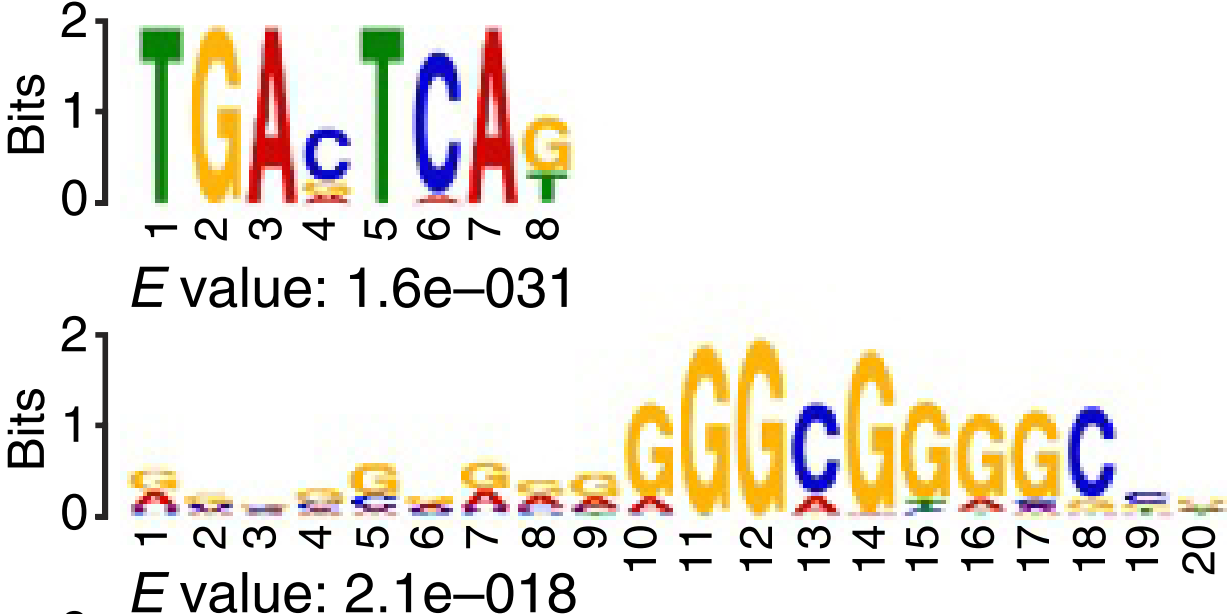
6.富集峰序列结构分析(Motif)
Motif为基因组序列中具有统计学显著性的保守序列模式。云序生物对富集峰序列进行Motif分析,挖掘糖基化相关区域潜在的序列特征,为探索其潜在调控机制提供参考。
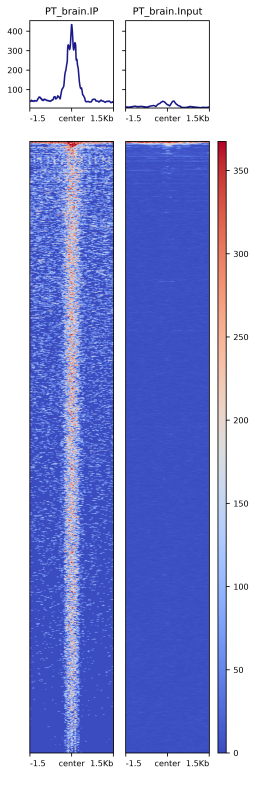
7.富集峰丰度热图(Heatmap)
利用富集峰位点的坐标信息,统计富集峰分布密度并绘制热图,从而可视化糖基化相关染色质在组间的丰度变化。
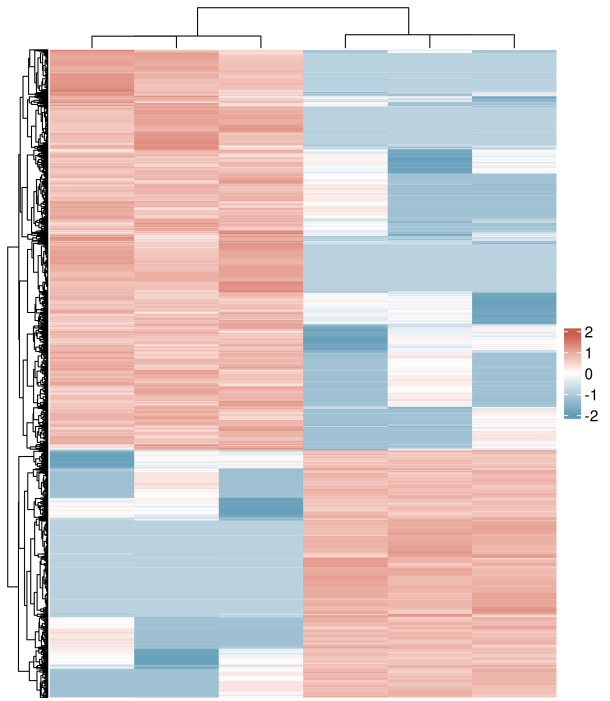
8.聚类分析(Cluster)
利用颜色的变化直观展示不同样本(或分组)间各富集区域的信号强度变化模式,并通过层次聚类对富集峰或样本进行分组,以揭示具有相似信号模式的富集峰簇以及样本间的相似性关系。
9.火山图(Volcano)
直观地展示两组样本之间富集峰信号差异的统计学显著性与变化幅度。
-
样本要求:
样品类型
组织或细胞样品,其它类型样品请详询。
样品量:
a)细胞:1×10^8,活细胞数量 > 90%
b)组织:动物 >500 mg;植物 >5 g 以上样品量适用于心、肝、脾、肺、肾、以及叶片等常见样品,特殊样品请详询。
样品收集与保存:
GlycoChIP-Seq样品需要终浓度为1%甲醛交联,不可加Trizol等裂解液,交联后的细胞沉淀-80℃保存。
具体请联系销售或后台工作人员,查看《云序生物样品采集保存及运输指南》。
样品运输:细胞和组织样品干冰运输。

产品中心
Product Center


关于我们
云序生物是国家高新技术企业及ISO9001认证单位,以RNA修饰组、表观遗传组与时空组学为特色,依托高通量测序平台,以“技术创新+全链条服务”为核心,通过北大授权的GLORI技术应用、临床微量样本技术优化及单细胞-空间多组学整合能力,持续推动表观遗传与转录组学发展。
技术服务

上海云序二维码

云序生物二维码
关注我们
